
最近我看到英伟达和Mercor之间的关系又往前走了一步:英伟达正在讨论投资这家AI数据公司,新一轮融资可能把Mercor估值推到200亿美元。
这笔交易还在讨论阶段,投资金额和融资总规模都没有公开。更有意思的是双方已经存在一层很深的业务关系。英伟达上一季度向Mercor支付了数千万美元,采购专家生产的数据,用于开发两款新的Nemotron模型。
一边采购,一边考虑入股。英伟达对Mercor的兴趣落在一个非常具体的产品环节:当基础模型进入后训练和智能体阶段,科学、法律、金融、工程等领域的专业判断,正在成为决定模型能不能处理复杂任务的新约束。
AI产业早期争夺的是网页文本和GPU。现在模型要进入专业工作流,稀缺性开始转向专家判断、评测环境和可验证反馈。
200亿美元买的,是专业判断的入口
Mercor在2023年成立,最初做AI招聘,随后把能力转向前沿模型的数据生产。它组织律师、医生、科学家、工程师、金融从业者和软件开发者,让这些人设计任务、撰写答案、审阅模型输出,并搭建更接近真实工作的评测环境。
这里和传统数据标注已经有明显区别。给图片画框、给文本贴标签,主要解决模型能不能识别;专家数据解决的是模型能不能在高价值任务里做出可靠判断。法律先例怎么权衡,工程方案如何取舍,复杂财务信息怎样交叉验证,都需要掌握行业语境的人来定义什么算好答案。
Mercor官方披露,它连接顶级AI实验室和大型科技公司,业务覆盖训练数据、模型评测、基准测试和强化学习环境。这个位置卡在模型能力提升的反馈回路里:专家先把任务和标准写清楚,模型完成后再被评价,新的反馈继续进入后训练。
Nemotron需要的,不是更多网页文本
Nemotron是英伟达面向智能体推出的开放模型家族。英伟达对它的定位很明确:模型需要长时间运行、调用工具、处理多步骤任务,还要在速度、准确率和推理成本之间找到平衡。
这种能力很难只靠扩大预训练语料获得。公开网页能提供广度,专业任务需要更细的评价标准。模型写出一份合同、诊断建议或工程方案后,质量往往取决于遗漏了什么、权重怎么分配、边界条件有没有处理。答案可能读起来流畅,专业人士仍能迅速发现它在关键步骤上失真。
合成数据可以降低成本、扩大规模,但复杂任务仍需要人来设定边界和验收标准。越靠近法律、医疗、金融和工业系统,错误成本越高,反馈数据越不能只看数量。英伟达采购Mercor的服务,等于承认开放模型的竞争力需要持续补充高质量后训练材料。
芯片决定模型能跑多快,专家数据决定模型在复杂任务上往哪个方向改。英伟达把两端放进同一个生态,Nemotron才有机会从开放权重走到可用的企业智能体。
收入翻倍很快,估值还要拆开看
Mercor的增长速度解释了资本为何愿意给出高价格。公司在2025年10月完成3.5亿美元C轮融资,估值100亿美元。现在讨论中的价格达到200亿美元,十个月左右再翻一倍。
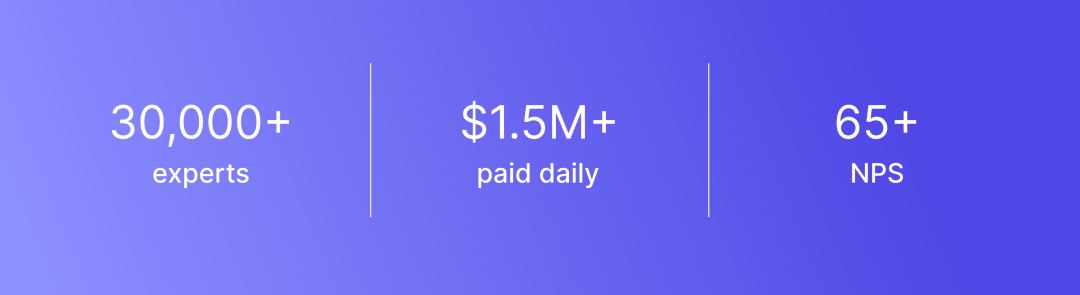
2026年6月,Mercor年化总收入的市场口径已经超过20亿美元,约为年初两倍。这个数字很强,但不能直接套用软件公司的收入倍数。Mercor要把大量款项支付给参与项目的专家,总收入、净收入和毛利之间可能存在明显差距。
估值能不能站稳,我会按四个变量排序。第一是扣除专家支出后的净收入和毛利;第二是头部实验室的客户集中度;第三是同一批专家和评测环境能否被重复使用;第四是项目能否从一次性数据生产变成持续的模型改进合同。
如果每个新模型都要重新招人、重新设计流程,业务规模很大,利润率仍可能受限。若Mercor能把专家网络、任务设计和评测基础设施沉淀为可复用平台,200亿美元对应的才是一条持续扩张的AI数据层。
英伟达开始锁定模型的知识供应链
英伟达过去擅长锁定先进封装、HBM、网络和整机系统。Mercor代表的是另一条供应链:谁能组织最合适的专家,谁能设计更接近真实工作的任务,谁能更快把模型缺陷变成下一轮训练数据。
对英伟达来说,投资供应商有三层价值。它能提高Nemotron所需数据的可获得性;能让开放模型的训练、评测和反馈节奏更稳定;还能把芯片、模型、工具链和数据伙伴连接成一套更完整的企业AI方案。
这条路线也会改变AI产业的分账。GPU继续拿走大额资本开支,模型公司承担研发和推理成本,专家数据平台则在模型进入专业场景时收取知识组织费。模型越接近真实岗位,后一项支出的占比越可能上升。
后续验证并不复杂:看英伟达对Mercor的采购能否持续,看双方是否把合作扩展到更多Nemotron模型,看Mercor的净收入和毛利能否跟上总收入,也看它能不能降低对少数前沿实验室的依赖。
英伟达看中的,是Mercor把分散的专家判断组织成可持续、可验证训练信号的能力。AI下一阶段最重要的稀缺资源,是能够进入专业工作流、定义好答案并反复校验模型的人类知识反馈。
(科技责编:拓荒牛
 )


 晋ICP备17002471号-6