
当地时间 11 月 4 日,苹果机器学习团队在预印本平台 arXiv 提交了一篇名为《Perceptive Humanoid Motion from Simulation》的论文,公开了他们的人形机器人全自主控制系统 HALO。
没有动捕服,没有遥操作员,也没有给测试场地预先扫描 3D 地图。在宇树科技 29 个自由度的 G1 人形机器人上,这套系统在 6 个完全未知的真实家庭与办公环境里跑了 360 次单项动作测试,完成了坐沙发、钻桌底、侧身过门缝等一系列动作,平均测试成功率达到91%。
整个系统的训练数据全部来自计算机里的虚拟仿真,相关的完整代码也已在 GitHub 开源。
01
纯仿真不是无人工程
02
慢想、快算、贴地跑
03
掉到 50% 的两个死穴
01
PIPELINE
仿真数据不是黑盒,人工工程藏在规则里
很多人对纯仿真路线有一个误解,以为只要把大模型扔进物理引擎,机器人就能自行悟出物理世界的规律。
真实情况完全相反。苹果团队在这篇论文里展示的,是一套极其严密的程序化工程管线:它虽然摆脱了现场真机遥操作的肉身消耗,但并没有脱离人工设计的精密规则。
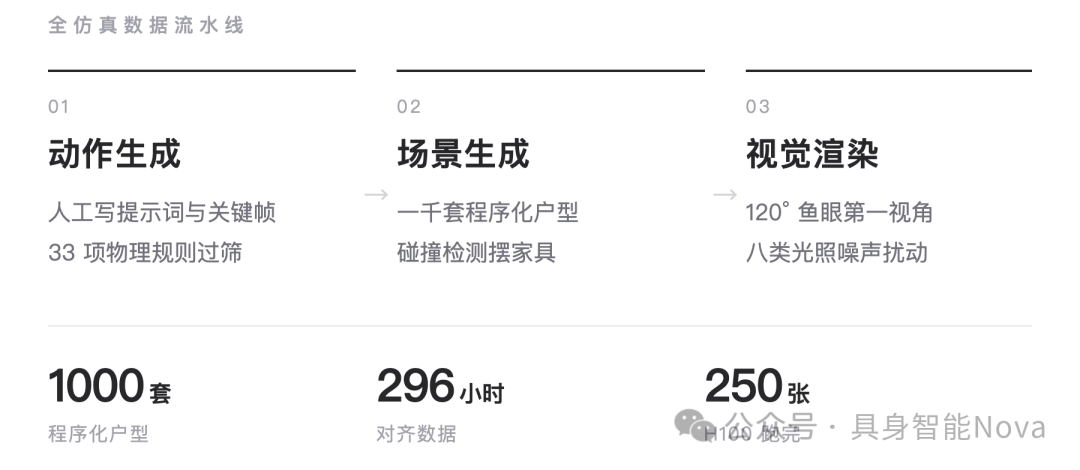
要让机器人学会一项新技能,第一步依然需要工程师人工编写提示词,并定义动作的关键帧与路径点。
这些动作并不是凭空捏造出来的。算法框架以人类运动动捕库和公开视频素材作为运动学先验,先在虚拟空间里把自然语言口令翻译成连续的全身关节轨迹。
由于虚拟世界里的骨骼模型经常会出现悬空滑动、肢体穿模或者非物理的突变跳跃,苹果专门设置了33 项刚性的几何与物理规则进行过滤。生成模块会采样多组候选动作,只有同时通过这 33 项物理规则筛选的动作序列,才会被系统保留下来。
接下来是场景生成。系统利用程序化工具搭建了1000 套户型各异的虚拟居室,把桌椅、沙发、半开的房门和纸箱随机撒布在房间里,并通过刚体碰撞检测寻找无碰撞的摆放位置。
为了彻底抹平真实世界与虚拟画面的视觉差距,苹果使用对齐真机硬件的 120 度鱼眼视场角进行第一人称渲染,并在画面上叠加了高光、弱光、冷暖色温偏置、高对比度、运动模糊以及椒盐噪声等 8 种视觉随机扰动。
这套数据流水线跑在 250 张 H100 GPU 上,总共合成了约 300 小时高质量的第一人称视觉、语言与全身动作对齐数据。
02
STACK
消化物理落差的三层机载时序
虚拟生成的数据无论经过多少轮规则清洗,在几何细节上依然无法百分之百复刻现实环境。
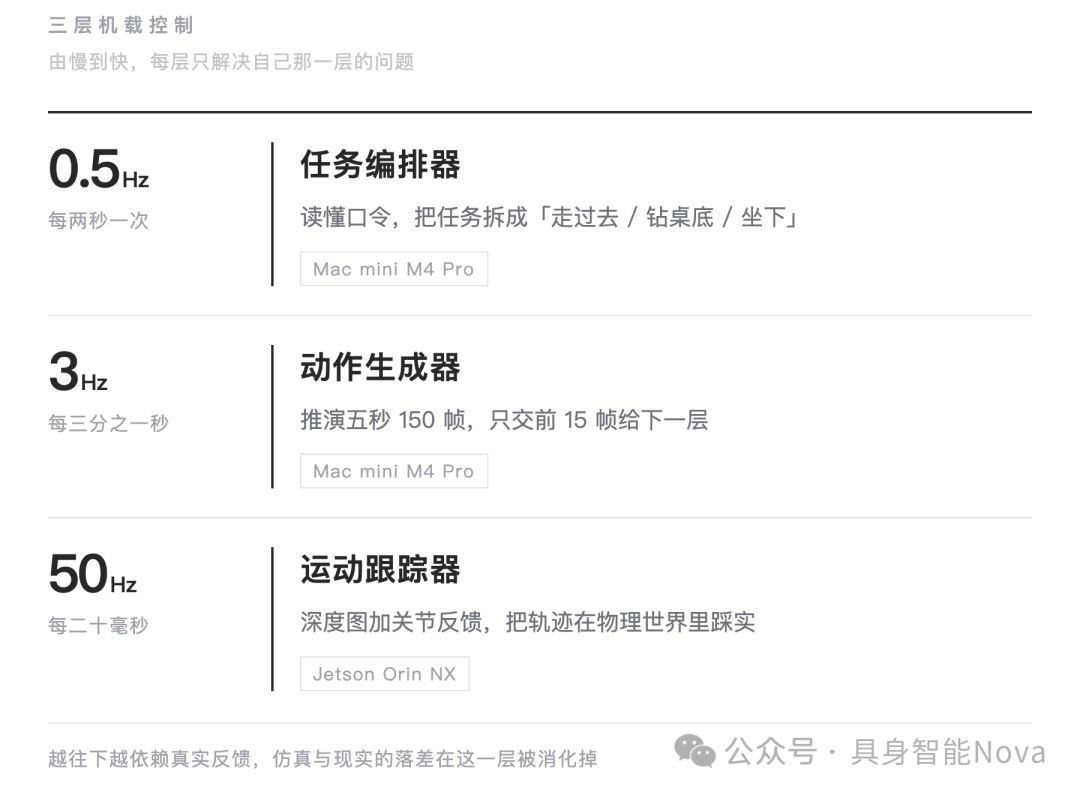
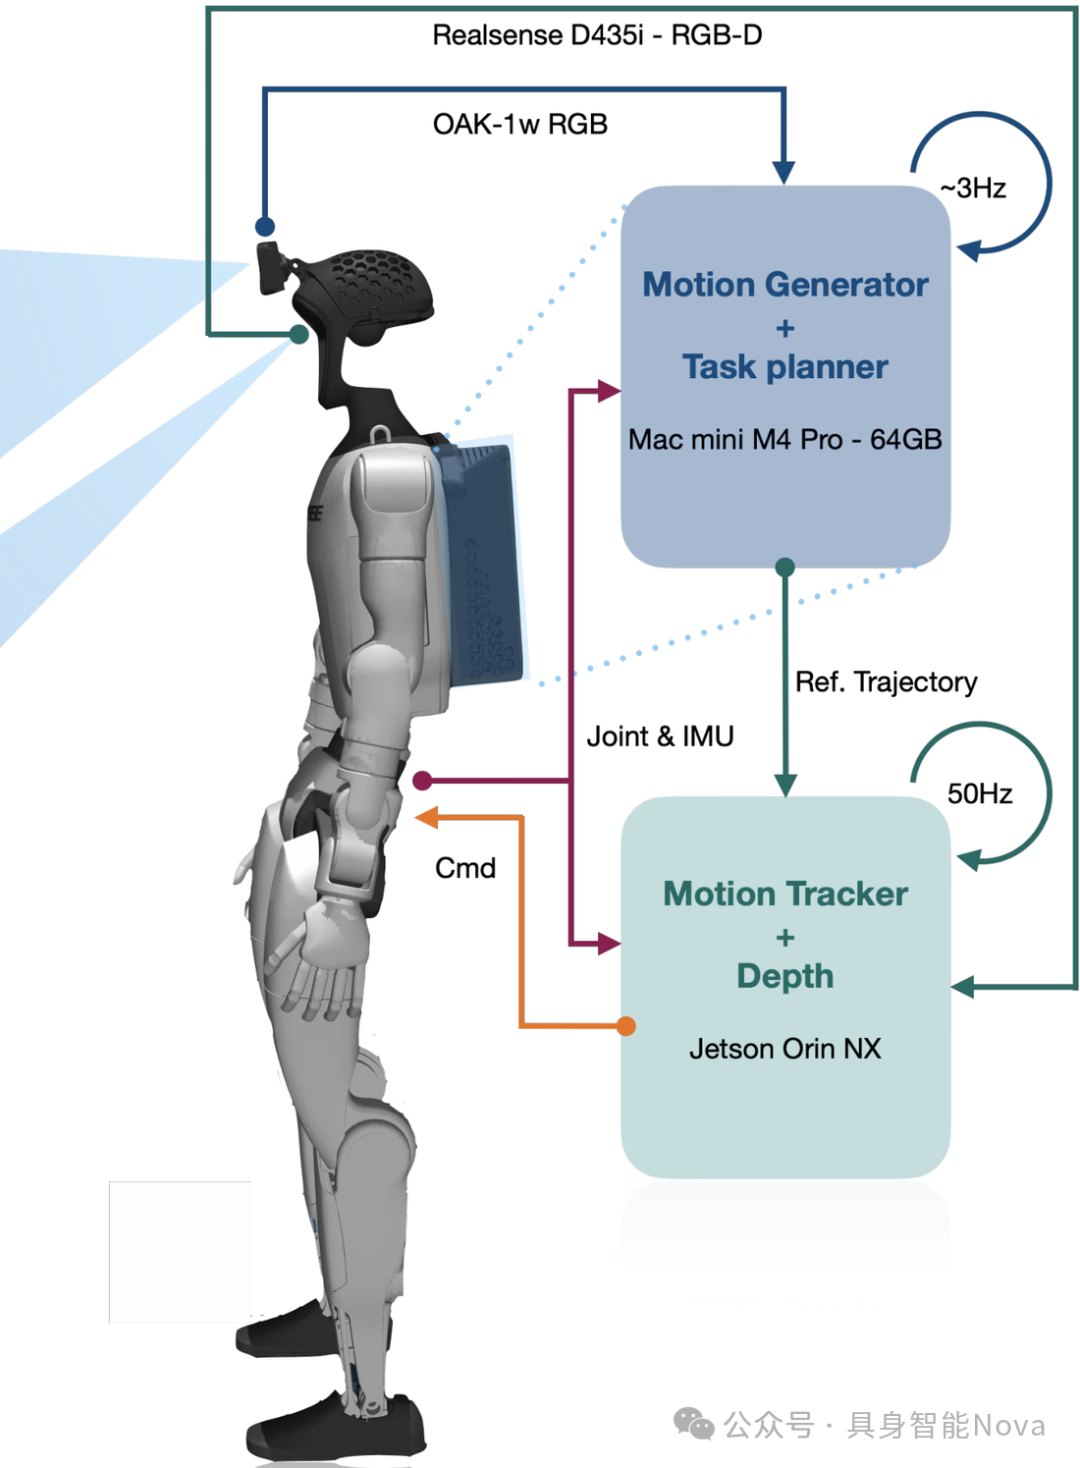
让这台宇树 G1 走上真实地板而不摔倒的,是苹果搭建的一套全机载运行、大小脑严格解耦的分层控制系统。整套系统分为三个层级,按照由慢到快的运行频率协同工作。
最顶层是任务编排器,运行频率大约是 0.5 Hz,每两秒做一次高层决策。这一层部署在机器人后背的计算背包上,调用了端侧视觉语言模型(论文选用 Qwen3.5-2B 级别的端侧多模态模型)。它负责看懂操作员的口令,结合 120 度广角相机的实时彩色画面,把任务拆成「走到桌子前」「屈身钻过桌面」或「坐下」等明确的阶段性目标。如果当前步骤执行成功就推进下一步,遇到障碍则触发重试。
中间层是全身动作生成器,运行频率提高到了 3 Hz,大约每三分之一秒重算一次轨迹。它由冻结权重的图像编码器与扩散变压器(DiT)解码器组成,基于流匹配架构推演动作。只要收到顶层的子任务指令和当前画面,它就会快速推演未来 5 秒内全身上下 29 个关节以及身体重心在三维空间中的运动轨迹,总共输出150 帧动作数据。
这里最核心的机制是实时分块。
虽然模型推算了未来 5 秒的动作,但系统每次只锁定前 0.5 秒(即前 15 帧)的轨迹提交给下层执行,并把这 15 帧作为无噪声的干净输入反馈给下一次推演。剩下的 4.5 秒轨迹,随时根据机器人眼睛看到的最新画面推倒重算。
最底层是以50 Hz 极高频运行的运动跟踪器。它部署在机载嵌入式计算核心上,输入只有两个:一个是前向偏下 55 度安装的深度相机画面,另一个是 29 个关节自带的编码器角度与角速度。运行在这一层的强化学习策略网络只专心干一件事:把中层下发的那 0.5 秒动作轨迹在物理世界里踩实,实时输出每个电机的扭矩与位置指令。
「大模型负责看全局想目标,扩散模型负责高频更新未来姿势,强化学习网络负责贴地抗冲击。」
这种软硬件时序上的分级缓冲,把仿真数据在物理精度上的毛刺彻底消解在了机载闭环里。
03
FAILURE
50% 成功率背后的两个物理死穴
在单项测试中,HALO 展现了极高的稳定性。
在 6 个未经过任何测绘建模的陌生环境里,机器人进行了 360 次单项动作测试,整体平均成功率达到 91%。其中坐椅子和坐沙发的成功率是 84%,侧身挤门缝、推移箱子以及桌下匍匐也保持了极高的一致性。
91%
单项平均 · 360 次
84%
坐椅子与沙发
但在三步连续复合任务测试中,系统的综合成功率下滑到了 70%。
当测试项目变成「俯身通过障碍—走向目标—推箱子」这一连贯组合时,任务成功率进一步跌落到了 50%。
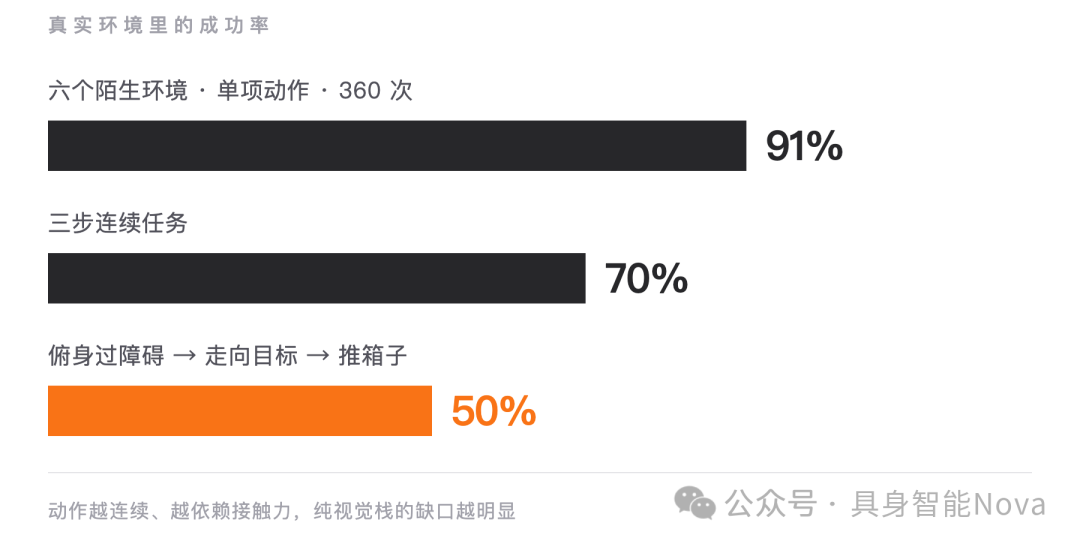
这个数据的下滑,直接暴露了目前纯视觉控制栈难以回避的两个工程短板:
第一个短板是视场角盲区与物体遮挡
机器人头部的传感器视场角是固定的。当机器人按照指令深度俯身去推箱子时,整个躯干必须大幅度前倾。一旦前倾角度过大,被推的纸箱或者前方的地面障碍物就会直接滑出相机的视野边缘。当视觉输入丢失,中间层的动作生成器就只能依靠上一时刻的记忆推算,极易在持续推进中产生轨迹漂移。
第二个短板是触觉感知的缺失
整套系统的数据链路完全建立在视觉画面与关节编码器的运动学位置上,没有任何专门的触觉传感器来测量手掌接触物体表面的法向压力与滑动摩擦力。推箱子是一项重度依赖接触力自适应的任务,箱子的自重、地面的粗糙程度以及箱底与地面的摩擦力变化都非常敏感。由于无法实时感知手指受力,机器人很容易在阻力突变时手掌滑脱,或者推力失衡导致身体后仰失控。
苹果团队在论文中把引入触觉感知列为下一阶段的核心演进方向,原因正在于此。
04
BOUNDARY
仿真与真机示教的真实边界
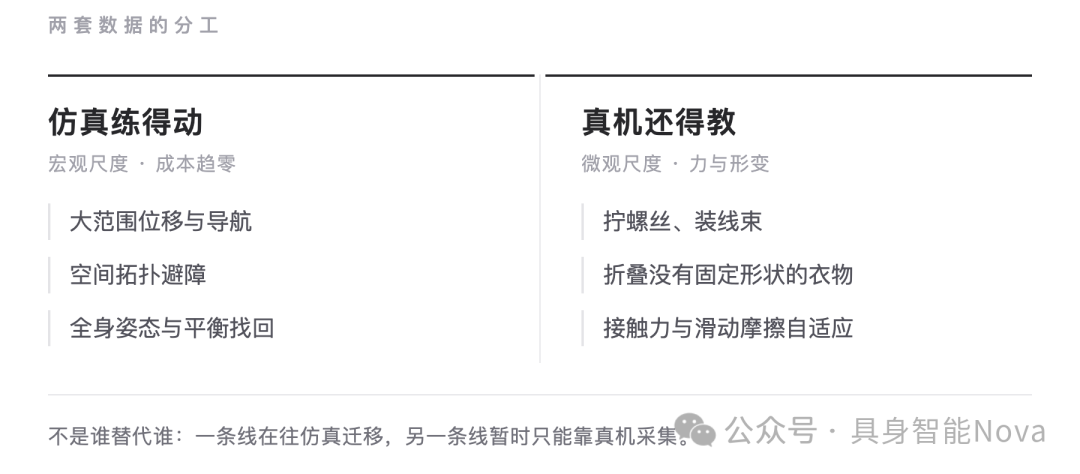
苹果这项成果厘清了具身智能两套数据来源的实际边界。
纯仿真的核心价值,在于以极低的边际成本解决大范围位移、空间拓扑避障以及全身姿态协调。在虚拟世界里,算法可以让机器人练习几十万次如何在摔倒边缘找回平衡,也可以让机器人在上千个房间里适应各种倾斜角度的门框,这些探索不会对实体硬件造成任何损耗。
真机遥操作的价值,依然稳稳落在微观尺度的精细力控与复杂接触操作上。
无论是拧紧一颗螺丝、装配一段线束,还是折叠一件没有固定形状的衣物,其背后的形变物理学和微观力学反馈,至今很难在虚拟仿真环境里通过纯代码完整重现。
这两套路线并不是相互替代的关系,而是各自对应着不同的物理尺度。全身运动与粗粒度的避障导航正在快速向低成本的仿真生成迁移,而真正的精细末端操作,依然需要真机采集提供细腻的动力学示范。
05
STRATEGY
苹果的算盘与硬件大宗化
在这次发布中,苹果的策略选择同样耐人寻味。
牵头这项研究的是计算机视觉与机器人领域的知名学者 Vladlen Koltun。团队在验证整套算法时,既没有动用内部保密的机械臂硬件,也没有自行打造一台人形机体,而是直接在市场上采购了中国宇树科技公开发售的 G1 人形机器人,并将整套技术栈部署在开源社区。
这个举动传递出一个明确的信号:苹果在具身智能上的投入重心,正在全面收敛到它最擅长的端侧系统架构、多模态端侧模型推理与数据基础设施上。
当机载算法能够直接驱动第三方的现成机体在复杂环境中完成长链路动作,机器人本体的机械加工与伺服硬件正在呈现出标准工业品的特征。对于行业而言,单纯堆叠关节电机与金属骨架已经很难构成独占壁垒;如何搭建一套能够在端侧芯片上实时运转、兼具视觉意图与动态自适应的控制系统,才是这门生意更难啃下的硬骨头。
(科技责编:李主编
 )


 晋ICP备17002471号-6