
完成数亿元A2轮融资,RoboScience机器科学要把机器人“大脑”搬上云|奇点融资报道
作者|米粒 编辑|奇博士
具身智能正在从技术验证走向规模化应用,开放场景的通用能力与落地成本是产业突破的关键;机器科学围绕这一命题构建了贯通数据、模型与本体的全栈技术体系,并持续提升跨本体、跨物体、跨任务的泛化能力。
从仿真数据、通用具身模型到自研机器人本体,再到云端API,RoboScience试图把机器人的操作能力从单一硬件中拆出来,做成一项可以反复调用的服务。
今年WAIC和WRC展台上,RoboScience机器科学做了个有趣的现场演示。搭载Visics的机器人实现了不同品牌灵巧手的30秒快速切换,无需重新训练即可执行操作,并能现场抓取观众随机提供的物品。

如果每更换一种硬件、每进入一个新场景,都需要重新采集数据、训练模型和调试控制系统,机器人的应用就很难摆脱项目制交付。模型能否跨本体、跨物体、跨任务复用,直接影响具身智能的商业化成本。
11月2日,RoboScience机器科学宣布完成数亿元A2轮融资,由琥珀资本、鸿瑞达投资、上海半导体产投联合领投,爽资本、360战投、国联民生资本、金鼎资本及多家上市公司平台跟投。
据了解,本轮资金将用于具身大模型迭代,以及物流、零售、工业等核心场景的POC验证和规模化落地,并进一步加强高端人才储备。
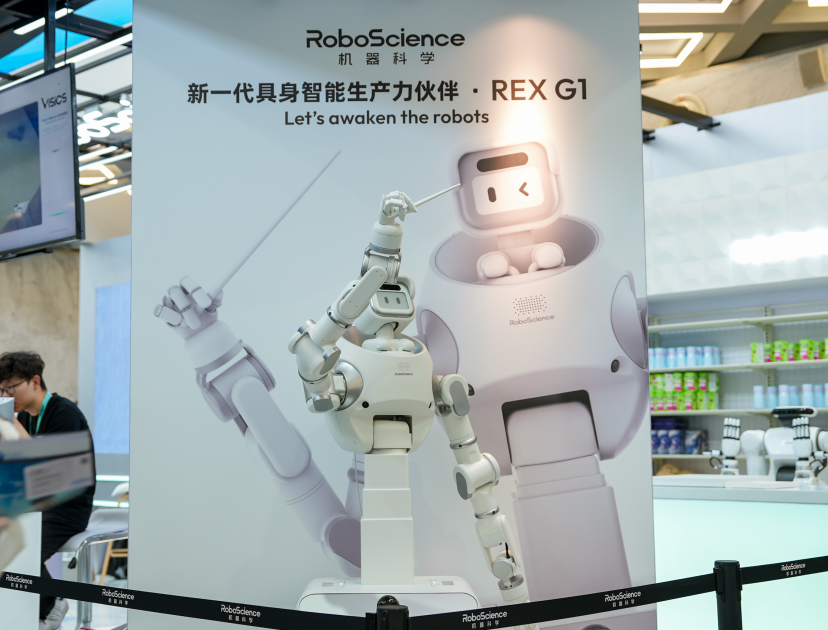
成立于2024年12月的机器科学,过去一年陆续推出物理仿真引擎RoboMirage、通用具身大模型Visics和轮式仿人形机器人REX G1,搭建起覆盖数据、模型和本体的技术体系。
如今,它又将Visics接入腾讯云,通过API向外部机器人开放模型能力。机器科学想用自研机器人验证模型,把模型能力封装成服务,RoboScience机器科学创始人兼CEO田野表示:“我们希望每一次场景落地,既能解决客户的实际问题,也能为通用能力的提升积累经验。本轮融资后,我们将持续迭代Visics,完善本体产品与EaaS服务,在真实作业中提升效率、准确率与泛化能力,降低具身智能的使用成本,推动具身智能走向千行百业。”
机器科学搭起全栈技术体系
从仿真数据到模型,再到能够在真实环境中工作的机器人,机器科学在不到一年的时间里,完成了具身智能研发体系的初步搭建。
2025年9月,公司发布自研物理仿真引擎RoboMirage;2026年6月,推出通用具身大模型Visics;8月,又发布首款轮式仿人形机器人REX G1。
传统方式主要依靠真机遥操作采集。真人控制机器人完成任务,记录过程中的视觉信息、动作轨迹和反馈。这类数据与真实作业环境接近,但采集需要设备、场地和人工,成本不低,数据规模也容易受到限制。
机器科学选择了“仿真+视频”的组合。
RoboMirage负责生成仿真数据,通过物理环境模拟,让机器人在虚拟场景中反复执行任务,与此同时,公司也在搭建视频自动标注和清洗管线,从互联网上的大量视频中提取物体运动和操作信息。
官方披露,目前RoboScience机器科学数据路线把单条数据的获取成本压到0.05元,降到了传统方案的1/20 到 1/200。2026年初至10月,RoboScience机器科学视频训练数据从100万小时突破到400万小时,仿真训练数据突破百亿次运动轨迹。
这些数字反映了机器科学在数据生产效率上的投入。对于具身模型来说,接下来还需要思考,规模不断扩大的数据,能在多大程度上转化为真实操作能力。
数据之外,Visics是整套体系的核心。
当前不少具身模型采用VLA(Vision-Language-Action)架构,将视觉信息和语言指令转化为机器人动作。机器科学给Visics设计了一套不同的架构VLOA(Vision-Language-Object-Action),将Object Trajectory,也就是物体的连续3D点云运动轨迹,作为模型之间的中间接口。
简单来说,Visics将操作过程拆成了两个相互衔接的部分:上层具身世界模型负责理解物体状态、预测物体接下来可能发生的运动;下层通用操作模型则将这些轨迹信息转化为不同机器人能够执行的控制信号。
这样设计的意义在于,模型不必始终绑定某一种机械臂或灵巧手。只要物体运动轨迹的表达方式相对统一,下层模型就有机会适配不同的硬件结构。
机器科学希望通过这种方式,提升模型在不同机器人本体、不同物体和不同任务之间的迁移能力。6月发布Visics时,公司也展示了家具拼装等复杂操作任务。
WAIC展台上的换手演示正是这一架构的直观展示。
不过,灵巧手只是机器人末端执行器的一部分。不同机器人还存在关节结构、运动范围、驱动方式、控制接口等差异。更换灵巧手后能够继续完成抓取,并不意味着换一台机器人就能直接执行所有任务。跨本体泛化仍需要更多不同硬件和真实任务的测试。
这也是REX G1存在的意义。
机器科学没有停留在模型研发,还推出了自研轮式仿人形机器人REX G1。按照公司披露,REX G1拥有22个自由度,双臂抱持能力为10公斤,作业高度覆盖0.1米至2米,主要面向物流、零售等需要移动和双臂协作的场景。
自研本体让公司能够直接测试模型在真实环境中的表现。机器人执行任务时产生的数据,可以用于分析操作失误、调整控制策略,再进入模型训练和仿真迭代。
这里有一个实际价值,如果模型表现不理想,研发团队能够同时检查数据、算法和硬件控制环节,不必完全依赖外部机器人厂商配合。
但全栈研发也意味着更大的投入。机器科学需要同时维护仿真引擎、模型和机器人产品。REX G1究竟会成为公司长期销售的主要产品,还是主要承担模型训练和能力验证的角色,仍需要看后续的商业布局。
至少在现阶段,自研本体为模型提供了一个能够反复测试的真实环境。接下来,能否让Visics在更多不同品牌、不同结构的机器人上稳定运行,将决定这套技术体系能否从自有产品走向更广泛的产业应用。
既卖整机也“卖能力”
具身智能公司大多在模型、数据、硬件和场景之间寻找自己的组合方式。要理解机器科学在行业中的位置,先要看清赛道正在形成的分工:大家最终交付给客户的,到底是机器人,还是机器人的“能力”。
目前行业大致沿着两条路线展开,一条是整体交付,自研模型和本体,带着整机进入具体场景,在应用中积累数据。典型代表是银河通用,其Galbot机器人已经进入零售、工业等场景,今年9月还在上海的老百姓大药房做起了药品盘点、补货和取送。
另一条是能力供给,即把模型、仿真平台或数据工具做成产品,服务其他机器人厂商和开发者。灵初智能的模型加数据产品组合、穹彻智能的具身大脑和开发工具链、星海图覆盖训练到部署的研发平台,都在这个方向上。
两条路线没有绝对的高下,但商业逻辑不同,前者离场景更近、收入更直接,代价是每进入一个新场景都要重新适配;后者一旦被采用,服务的就是整个行业,前提是能力足够通用。
机器科学选择的是“组合路线”,自研本体,但不把模型服务限定在自家硬件上;建设仿真和数据体系,同时通过云端API向外部开发者开放模型。
这种“模型即服务”的设想,在海外已经有了更激进的样本。
10月13日,Physical Intelligence开放Pi API Beta,开发者可以上传机器人数据,在其算力设施上微调模型,再通过云端接口部署推理;同月,Dream Labs推出Dream-1模型并开放API,公开标价每小时3美元,主打让模型控制此前从未见过的机器人。这两家公司押注的都是具身模型可以像大语言模型一样,以服务的方式卖给整个机器人产业。
机器科学既有自己的REX G1,可以在真实环境里测试模型;又在尝试通过Visics和EaaS,向外部机器人开放操作能力。
本轮投资方琥珀资本表示,具身智能正在从技术验证走向规模化应用,开放场景的通用能力与落地成本是产业突破的关键;机器科学围绕这一命题构建了贯通数据、模型与本体的全栈技术体系,并持续提升跨本体、跨物体、跨任务的泛化能力。在投资方的预期里,机器科学有机会“逐步成长为通用具身智能时代的重要基础设施平台”,本轮数亿元融资,可以看作产业资本对这条组合路线的一次投票。
今年7月,机器科学与腾讯云达成战略合作,将Visics接入腾讯云,并通过API开放调用。
机器科学把这项服务称为EaaS(Embodied-AI-as-a-Service)。
官方介绍,EaaS将具身模型封装成可调用的机器人操作能力,开发者不必从零开始训练模型,就可以通过接口获取抓取、感知等操作能力,并适配不同形态的机器人和末端执行器。
这意味着,机器科学的客户不再局限于需要购买REX G1的企业,也可以是已经有机器人硬件,却缺少通用操作模型的厂商。
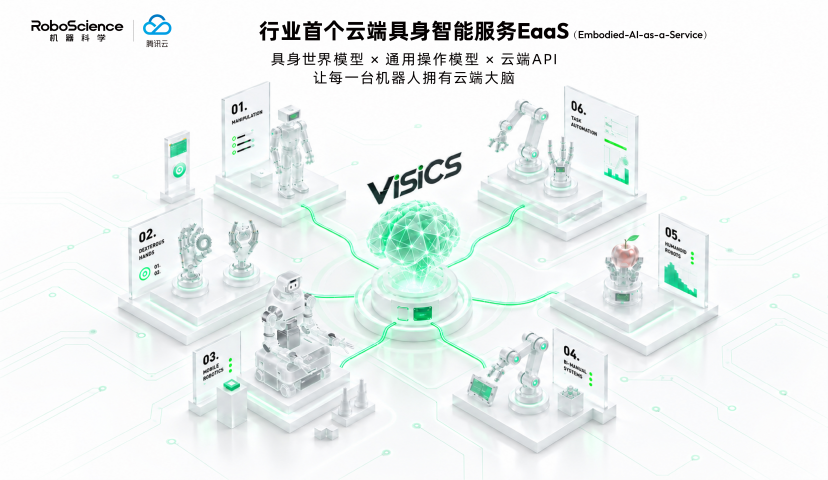
机器科学也由此获得了一种不同于销售整机的收入可能:客户部署了多少机器人、调用了多少模型能力,都可能成为后续服务收费的依据。
这种方式与传统机器人项目交付存在差别。
过去,机器人厂商往往需要围绕客户的设备和场景进行单独适配。一个项目完成后,团队还要面对下一家客户的硬件结构、任务流程和工作环境,重复投入开发与调试。
模型服务希望把一部分重复工作沉淀为标准化能力。客户通过API调用模型,机器科学负责模型迭代、推理服务和能力升级。
从商业逻辑看,收入来源有机会从整机采购和项目部署,扩展到模型调用、服务订阅和长期授权。
API开放只是产品形态,收费方式还没有完全确定。按照调用量收费,客户会计算完成一次任务需要多少调用、多少算力;按照机器人数量或服务周期收费,客户则会关注设备使用率和实际作业收益。
目前,RoboScience机器科学已在零售商超、物流等场景推进应用落地,在RoboScience机器科学创始人兼CEO田野看来,物流、零售等场景涉及多样化的物体、环境与任务,既能发挥通用操作模型的优势,也能积累丰富的真实作业数据,持续反哺模型迭代。不过机器科学尚未公开EaaS的详细价格体系、客户数量和实际调用数据。
其次是云端与端侧的分工。机器人不像软件,模型推理结果不能只停留在屏幕上。它需要控制机械臂、关节和末端执行器,实时处理接触、碰撞、力反馈和环境变化。
云端推理可以承担任务理解、操作策略生成等相对高层的工作,但机器人末端的高频运动控制和安全响应,仍然需要依靠本地控制系统完成。
这也是机器科学仍然需要自研本体、探索控制器和软硬件协同的原因,云端服务并不能取代机器人端侧的全部控制能力。
还有一个容易被忽略的问题,机器科学既开发REX G1,也希望为其他机器人厂商提供模型服务。对于潜在客户来说,这种身份需要进一步解释。
一家机器人厂商可能愿意采购独立的软件和云服务,却未必愿意让竞争对手接触自己的设备数据、任务流程和操作记录。尤其当模型服务商同时拥有自己的机器人产品时,客户会更加关心数据隔离、模型训练边界和商业利益冲突。
机器科学需要建立的不只是API接口,还包括客户能够信任的服务规则。
EaaS真正的价值,在于让一套模型能够被更多机器人持续使用。接口打通只是起点,客户愿不愿意长期付费,才是这门生意的关键。如果这条路走通,机器科学卖出的将不只是机器人,而是整个行业都可以调用的“操作能力底座”。
对一家成立不到一年的公司来说,这既是资本愿意下注的想象空间,也是每一个POC都要回答的问题。
(科技责编:李主编
 )


 晋ICP备17002471号-6