
Excel常用公式汇总之——姓名脱敏公式
在日常工作中,经常也会涉及到各类姓名、手机号、身份证号等信息,为了防止“数据外泄”,在发送给别人的时候往往需要进行脱敏处理。
什么是“脱敏处理”?
数据脱敏是指对某些敏感信息进行数据变形,实现隐私数据的可靠保护。
简单点来说就是将部分内容替换成星号“*”。
今天就来给大家介绍一些Excel中常用的数据脱敏公式。
今天先介绍第一类:姓名脱敏
规则:保持姓名字数不变的情况下,只显示姓氏(复姓只显示第一个字),其他信息都用*代替。
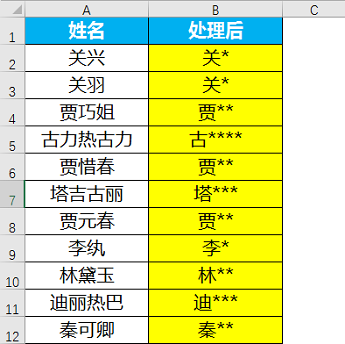
这类问题的特点是显示的字数固定,需要用*代替的字数不固定,下面介绍几个常用的公式。
公式1:=LEFT(A2,1)&REPT("*",LEN(A2)-1)

公式中的LEFT(A2,1)是截取姓名中的第一个字,REPT("*",LEN(A2)-1)的意思是将“*”重复姓名的字数-1次。
当LEFT的第二参数为1时可以省略,因此公式也可以修改为=LEFT(A2)&REPT("*",LEN(A2)-1)。
公式2:=REPLACE(A2,2,LEN(A2)-1,REPT("*",LEN(A2)-1))
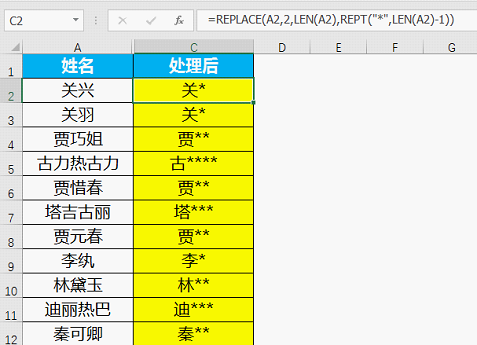
这个公式主要利用了REPLACE函数实现数据中的内容替换,REPLACE函数有四个参数,函数结构是:REPLACE(要进行替换的文本,从第几个字开始替换,要替换的字数,替换成什么内容)。
在本例中要进行替换的文本就是姓名所在的单元格,按要求是从第二个字开始替换,LEN(A2)-1表示要替换的字数比姓名的字数少一个,REPT("*",LEN(A2)-1)表示要替换的内容,这个和公式1是一样的。
公式3:
=SUBSTITUTE(A2,RIGHT(A2,LEN(A2)-1),REPT("*",LEN(A2)-1))
这个公式是利用SUBSTITUTE函数实现数据中的内容替换,函数结构是SUBSTITUTE (要替换的文本,旧文本,新文本,[替换第几个])。
与前两个公式的差别主要是第二参数,RIGHT(A2,LEN(A2)-1)表示姓名中第二个字后面的内容。
(职场责编:未找到用户
 )


 晋ICP备17002471号-6